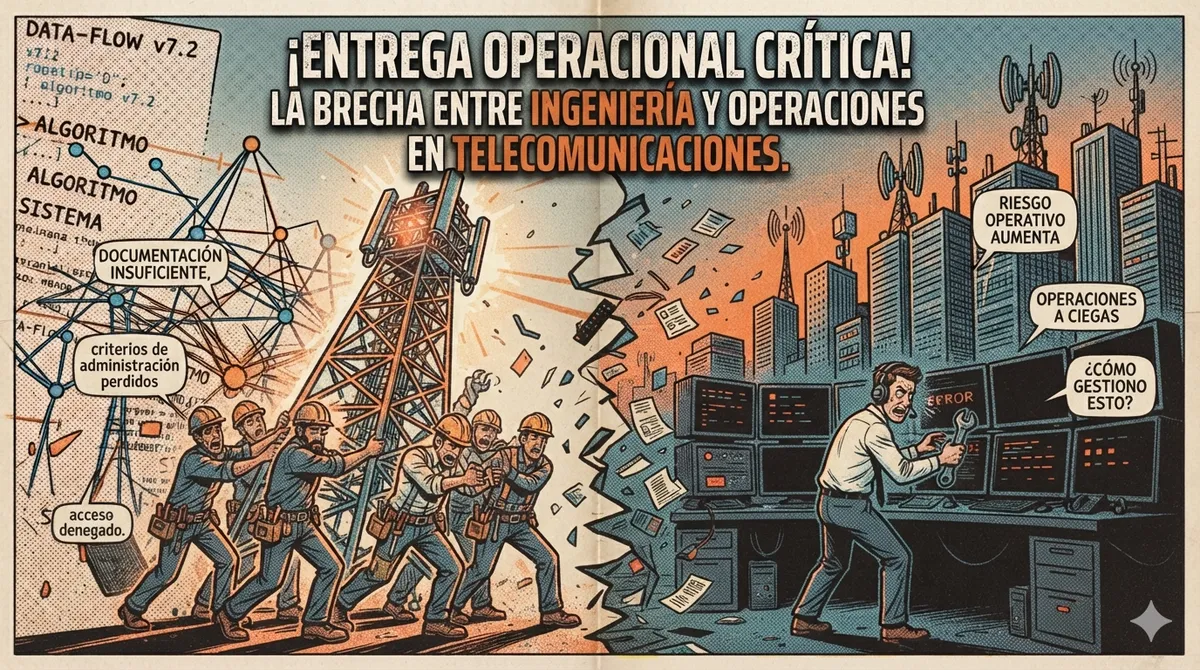
Del Deployment a Operaciones: cómo la industria gestiona la entrega de plataformas de telecomunicaciones
En la industria de telecomunicaciones, la entrega de una plataforma desde el equipo de ingeniería, implementación o deployment hacia el equipo de operaciones es uno de los momentos más críticos del ci
En la industria de telecomunicaciones, la entrega de una plataforma desde el equipo de ingeniería, implementación o deployment hacia el equipo de operaciones es uno de los momentos más críticos del ciclo de vida de un servicio. Aunque muchas veces se percibe como una actividad administrativa basada en la entrega de documentos, en realidad se trata de un proceso de aseguramiento operacional. Una plataforma puede estar desplegada, integrada y funcionando técnicamente, pero si operaciones no cuenta con la información, herramientas, accesos, procedimientos y criterios adecuados para administrarla, el riesgo operativo aumenta considerablemente. Incidentes mal gestionados, tiempos altos de resolución, dependencia excesiva del equipo de ingeniería, falta de visibilidad, escalaciones confusas e incumplimientos de SLA son algunas de las consecuencias más comunes de una transición incompleta. En el mercado, este proceso suele conocerse como:
- Handover to Operations
- Operational Readiness
- Service Transition
- Production Acceptance
- Go-Live Readiness
- Operational Acceptance Testing
Independientemente del nombre, el objetivo es el mismo: asegurar que una plataforma esté realmente lista para ser operada de forma estable, segura y sostenible.
¿Qué es el proceso de handover a operaciones?
El proceso de entrega a operaciones es la transición formal mediante la cual una plataforma, servicio o componente tecnológico pasa de estar bajo responsabilidad principal del equipo de ingeniería o proyecto a ser administrado por el equipo operativo. En telecomunicaciones, este proceso puede aplicar a múltiples tipos de plataformas, por ejemplo:
- Core de red.
- Plataformas OSS/BSS.
- Sistemas de monitoreo.
- Plataformas de provisión.
- Elementos físicos o virtualizados de red.
- Plataformas de voz, datos, mensajería o video.
- Aplicativos internos.
- Soluciones cloud-native.
- CNFs y VNFs.
- Plataformas de automatización.
- Sistemas de mediación.
- Plataformas de seguridad o gestión de tráfico.
El objetivo principal es asegurar que operaciones pueda:
- Monitorear la plataforma.
- Operarla diariamente.
- Resolver incidentes.
- Escalar problemas correctamente.
- Ejecutar cambios controlados.
- Administrar capacidad y performance.
- Cumplir los SLA acordados.
- Mantener continuidad del servicio.
- Entender dependencias, arquitectura y riesgos.
- Recuperar la plataforma ante fallas.
Cómo se maneja este proceso en la industria
En empresas maduras de telecomunicaciones, el handover no ocurre únicamente al final del proyecto. Por el contrario, se gestiona de forma progresiva desde etapas tempranas del diseño y despliegue. El enfoque moderno se basa en tres principios clave:
1. Operational Readiness desde el diseño
Las organizaciones líderes involucran a operaciones desde la fase de arquitectura y diseño. Esto permite identificar desde el inicio los requisitos necesarios para operar la plataforma de manera segura. En lugar de esperar al final del proyecto para preguntar:
“¿Operaciones puede recibir esta plataforma?” La pregunta correcta desde el inicio debería ser: “¿Qué necesita operaciones para soportar esta plataforma de forma estable, monitoreable y recuperable?” Este cambio de enfoque ayuda a evitar que una solución llegue a producción sin considerar aspectos críticos como:
- Monitoreo.
- Alarmamiento.
- Capacidad.
- Soporte.
- Seguridad.
- Respaldos.
- Accesos.
- Procedimientos operativos.
- Escalamiento.
- Continuidad del servicio.
Cuando operaciones participa tarde, los problemas suelen descubrirse cuando corregirlos es más costoso y riesgoso. Por eso, el mercado tiende cada vez más a incorporar revisiones operacionales desde las etapas iniciales del proyecto.
2. Checklist de aceptación operacional
El checklist sigue siendo una herramienta ampliamente utilizada en la industria. Sin embargo, en organizaciones maduras no se trata simplemente de verificar si un documento fue entregado, sino de confirmar si la información es completa, vigente, validada y útil para operar la plataforma. Un checklist típico de recepción operacional puede incluir:
- Arquitectura de la solución.
- Diagramas físicos, lógicos y funcionales.
- Dimensionamiento.
- Plan de conectividad.
- Matriz de dependencias.
- Matriz de responsabilidades.
- Procedimientos de operación.
- Runbooks.
- Manuales de soporte.
- Plan de escalamiento.
- SLA y OLA.
- Contratos de soporte.
- KPIs técnicos y de servicio.
- Umbrales de monitoreo.
- Alarmas configuradas.
- Integración con sistemas OSS/NMS.
- Procedimientos de backup y restore.
- Plan de continuidad.
- Plan de recuperación ante desastres.
- Gestión de usuarios y accesos.
- Evidencias de pruebas.
- Plan de rollback.
- Plan de capacitación.
- Contactos de soporte.
- Inventario.
- Configuración base.
- Licenciamiento.
- Riesgos conocidos.
- Restricciones operativas.
La diferencia entre una práctica básica y una práctica madura es que el checklist no se limita a marcar “entregado”, sino que valida si el contenido es realmente accionable para operaciones. Por ejemplo, no basta con entregar un documento de monitoreo. Es necesario validar que:
- Las alarmas estén creadas.
- Los umbrales sean correctos.
- El NOC tenga visibilidad.
- Exista un procedimiento ante cada alarma crítica.
- Los dashboards estén disponibles.
- Las alertas sean accionables y no generen ruido innecesario.
3. Marcos utilizados en el mercado
El proceso de entrega a operaciones suele apoyarse en diferentes marcos de trabajo. En telecomunicaciones, los más comunes son ITIL, DevOps/SRE y TM Forum.
ITIL y Service Transition
ITIL es uno de los marcos más utilizados para estructurar procesos de transición a operación. Desde esta perspectiva, una plataforma no debería entrar formalmente en producción sin estar integrada a los procesos de gestión de servicios. Algunos elementos clave son:
- Gestión de cambios.
- Gestión de incidentes.
- Gestión de problemas.
- Gestión de configuración.
- Gestión de niveles de servicio.
- Gestión de conocimiento.
- Gestión de disponibilidad.
- Gestión de capacidad.
- Gestión de continuidad.
Bajo un enfoque ITIL, antes de aceptar una plataforma, operaciones debería confirmar que:
- La plataforma está registrada en la CMDB.
- Existen procedimientos de atención de incidentes.
- Está definido el modelo de soporte.
- Están acordados los SLA y OLA.
- Hay documentación operacional.
- Se conocen los riesgos.
- Hay un proceso claro de escalamiento.
- Se definieron criterios de aceptación.
DevOps y SRE
En plataformas modernas, especialmente aquellas basadas en cloud, microservicios, contenedores, Kubernetes, CNFs o VNFs, muchas organizaciones adoptan prácticas de DevOps y Site Reliability Engineering, conocido como SRE. Este enfoque enfatiza la confiabilidad, automatización y observabilidad desde el diseño. Algunos elementos importantes son:
- Observabilidad.
- Métricas.
- Logs.
- Trazas.
- Dashboards.
- Alertas accionables.
- SLOs y SLIs.
- Runbooks.
- Automatización de despliegues.
- Automatización de recuperación.
- Postmortems.
- Error budgets.
- Pruebas de resiliencia.
Desde la perspectiva SRE, una plataforma no está lista para operar solo porque fue desplegada correctamente. Está lista cuando se puede medir, observar, diagnosticar, recuperar y mejorar continuamente.
TM Forum y eTOM
En telecomunicaciones, TM Forum y eTOM son referencias importantes para organizar procesos de negocio y operación. Estos marcos ayudan a alinear capacidades como:
- Aseguramiento de servicio.
- Gestión de recursos.
- Gestión de clientes.
- Gestión de servicios.
- Cumplimiento.
- Operación de red.
- Gestión de inventario.
- Gestión de fallas.
- Gestión de desempeño.
Aunque muchas organizaciones no implementan estos marcos de forma pura, sí toman conceptos de ellos para estructurar sus procesos operativos.
Fases típicas del proceso de entrega
Aunque cada empresa adapta el proceso según su estructura y madurez, en la industria suele seguirse una secuencia similar.
Fase 1: planificación de la transición
La transición debe planificarse desde etapas tempranas del proyecto. En esta fase se define qué se entregará, quién lo recibirá y bajo qué condiciones. Actividades comunes:
- Identificar stakeholders.
- Definir alcance de la plataforma.
- Identificar áreas impactadas.
- Establecer criterios de aceptación operacional.
- Definir responsables de ingeniería, operaciones, seguridad, arquitectura y proveedores.
- Identificar dependencias técnicas.
- Revisar riesgos iniciales.
- Acordar fechas clave.
- Definir entregables obligatorios.
- Establecer estrategia de capacitación.
- Definir modelo de soporte post go-live.
El resultado esperado es un plan claro de transición, con responsables, fechas y criterios de aceptación.
Fase 2: construcción de documentación operacional
Durante el despliegue, el equipo responsable debe generar la documentación necesaria para que operaciones pueda administrar la plataforma. La documentación debe responder preguntas como:
- ¿Qué hace la plataforma?
- ¿Qué servicios soporta?
- ¿Dónde está desplegada?
- ¿Cómo se conecta?
- ¿Cuáles son sus componentes?
- ¿Cuáles son sus dependencias?
- ¿Qué sucede si falla?
- ¿Cómo se monitorea?
- ¿Cuáles son sus KPIs?
- ¿Qué alarmas genera?
- ¿Qué hacer ante una falla?
- ¿A quién se escala?
- ¿Qué procedimientos deben ejecutarse regularmente?
- ¿Cómo se recupera el servicio?
- ¿Qué riesgos conocidos existen?
Un error común es entregar documentación técnica extensa, pero poco útil para la operación diaria. La documentación operacional debe ser clara, práctica y orientada a la acción.
Fase 3: validación técnica y pruebas
Antes de la aceptación formal, se deben ejecutar pruebas para confirmar que la plataforma está lista desde el punto de vista funcional y operacional. Pruebas frecuentes en la industria:
- Pruebas funcionales.
- Pruebas de integración.
- Pruebas de conectividad.
- Pruebas de carga.
- Pruebas de capacidad.
- Pruebas de performance.
- Pruebas de alta disponibilidad.
- Pruebas de failover.
- Pruebas de backup.
- Pruebas de restore.
- Pruebas de monitoreo.
- Pruebas de alarmas.
- Pruebas de seguridad.
- Pruebas de recuperación.
- Pruebas de operación diaria.
- Pruebas de rollback.
Este tipo de revisión puede conocerse como:
- Operational Acceptance Testing
- Production Readiness Review
- Operational Readiness Review
- Service Readiness Review
La clave es validar no solo que la plataforma funcione, sino que pueda ser operada y recuperada bajo condiciones reales.
Fase 4: transferencia de conocimiento
Una entrega documental sin transferencia de conocimiento suele ser insuficiente. El equipo de operaciones necesita comprender la plataforma, no solo recibir archivos. Por eso, en el mercado son comunes las sesiones de knowledge transfer entre ingeniería, proveedores y operaciones. Estas sesiones suelen cubrir:
- Arquitectura general.
- Flujo de tráfico.
- Flujos transaccionales.
- Componentes críticos.
- Procedimientos normales.
- Procedimientos de emergencia.
- Alarmas relevantes.
- KPIs.
- Herramientas de diagnóstico.
- Escenarios de falla.
- Escalamiento.
- Restricciones conocidas.
- Lecciones aprendidas durante el despliegue.
También es recomendable realizar demostraciones prácticas, simulacros de incidentes y revisión conjunta de runbooks.
Fase 5: aceptación formal
Una vez cumplidos los criterios definidos, operaciones puede aceptar formalmente la plataforma. La aceptación puede tomar diferentes formas:
- Aceptación total.
- Aceptación parcial.
- Aceptación condicionada.
- Aceptación para piloto.
- Aceptación para producción limitada.
- Rechazo con observaciones.
En organizaciones maduras, la aceptación no depende únicamente de que la plataforma esté funcionando. También se evalúa si está lista para ser:
- Operada.
- Monitoreada.
- Soportada.
- Escalada.
- Recuperada.
- Administrada.
- Auditada.
- Mantenida.
Si existen pendientes, estos deben quedar documentados con responsable, fecha compromiso y nivel de riesgo.
Fase 6: hypercare post go-live
Después de la entrega, muchas empresas establecen un periodo de hypercare o soporte reforzado. Durante este periodo, ingeniería, proveedores y operaciones trabajan juntos para estabilizar la plataforma en producción. El hypercare puede durar días, semanas o meses, dependiendo de la criticidad del servicio. Actividades típicas:
- Seguimiento diario o semanal.
- Revisión de incidentes.
- Ajuste de umbrales.
- Corrección de documentación.
- Optimización de alarmas.
- Validación de KPIs.
- Revisión de capacidad.
- Cierre de pendientes.
- Soporte directo de ingeniería.
- Soporte directo de proveedores.
- Transferencia final de conocimiento.
- Revisión de lecciones aprendidas.
Un buen hypercare debe tener criterios claros de salida. Por ejemplo:
- No existen incidentes críticos abiertos.
- Los KPIs están estables.
- Las alarmas están ajustadas.
- Operaciones puede resolver casos recurrentes.
- La documentación fue corregida.
- Los pendientes críticos fueron cerrados.
- El modelo de soporte regular está activo.
Principales complicaciones del proceso
El handover a operaciones es complejo porque combina tecnología, procesos, personas, proveedores y responsabilidades. Estas son algunas de las complicaciones más frecuentes en el mercado.
1. Documentación incompleta o desactualizada
Uno de los problemas más comunes es que la documentación se prepara al final del proyecto y no refleja exactamente la implementación real. Ejemplos típicos:
- Diagramas desactualizados.
- IPs incorrectas.
- Puertos no documentados.
- Procedimientos genéricos.
- Manuales copiados de otro proyecto.
- Falta de contactos de soporte.
- Ausencia de matriz de escalamiento.
- Dependencias no registradas.
- Riesgos no documentados.
- Diferencias entre diseño e implementación real.
Para evitarlo, la documentación debe construirse y validarse durante todo el ciclo de despliegue, no únicamente al final.
2. Falta de criterios claros de aceptación
Si no existe una definición objetiva de “listo para operar”, cada equipo puede interpretarlo de forma diferente. Por ejemplo:
- Ingeniería puede considerar que la plataforma está lista porque pasó pruebas técnicas.
- Operaciones puede rechazarla porque no tiene monitoreo o procedimientos.
- Seguridad puede detenerla por controles pendientes.
- Negocio puede presionar por salir a producción aunque existan riesgos abiertos.
- El proveedor puede considerar cerrado su trabajo aunque existan vacíos operativos.
Por eso, el mercado tiende a usar criterios de aceptación definidos desde el inicio.
3. Monitoreo insuficiente
Una plataforma sin monitoreo adecuado es difícil de operar. Problemas comunes:
- Alarmas no integradas al NOC.
- Dashboards inexistentes.
- Umbrales mal definidos.
- Exceso de alarmas irrelevantes.
- Falta de alarmas críticas.
- No se monitorean dependencias.
- No se monitorean KPIs de servicio.
- No existe correlación de eventos.
- Las alertas no tienen procedimiento asociado.
Una buena práctica es exigir que el monitoreo esté configurado, probado y aceptado antes del go-live.
4. Dependencia excesiva de ingeniería o proveedores
Cuando operaciones no recibe suficiente conocimiento, termina dependiendo del equipo de ingeniería o del proveedor para resolver cualquier incidente. Esto genera:
- Mayor tiempo de resolución.
- Escalaciones innecesarias.
- Riesgo fuera de horario laboral.
- Sobrecarga del equipo de ingeniería.
- Falta de autonomía operativa.
- Incumplimiento de SLA.
- Pérdida de conocimiento interno.
El handover debe reducir esta dependencia mediante documentación clara, capacitación, runbooks y un modelo de soporte escalonado.
5. SLA mal definidos
En algunos casos, los SLA se definen sin validar si la arquitectura y el modelo operativo pueden soportarlos. Por ejemplo, se puede prometer alta disponibilidad, pero:
- No existe redundancia real.
- No se ha probado failover.
- No hay soporte 24×7.
- El proveedor no garantiza tiempos adecuados.
- No hay procedimientos de recuperación.
- El monitoreo no detecta fallas a tiempo.
- No existen OLA internos alineados.
Por eso, los SLA deben estar respaldados por arquitectura, soporte, operación, monitoreo y procedimientos reales.
6. Falta de integración con procesos operativos
Una plataforma puede estar funcionando técnicamente, pero si no está integrada a los procesos operativos internos, será difícil de administrar. Aspectos clave:
- Registro en inventario.
- Alta en CMDB.
- Integración con herramientas de tickets.
- Definición del proceso de cambios.
- Gestión de incidentes.
- Gestión de problemas.
- Gestión de accesos.
- Gestión de capacidad.
- Gestión de configuración.
- Gestión de continuidad.
La recepción operacional debe validar que la plataforma no solo exista, sino que esté integrada al ecosistema operativo de la empresa.
7. Seguridad y accesos no resueltos
Otro problema frecuente es entregar una plataforma sin resolver correctamente la gestión de accesos. Riesgos comunes:
- Usuarios compartidos.
- Cuentas sin dueño.
- Permisos excesivos.
- Falta de trazabilidad.
- Credenciales no gestionadas correctamente.
- Accesos temporales que quedan permanentes.
- Cuentas de proyecto usadas en producción.
- Falta de auditoría.
- Certificados próximos a vencer sin responsable claro.
La seguridad debe formar parte del proceso de aceptación operacional, no tratarse como un pendiente posterior.
Cómo lo maneja el mercado actualmente
La tendencia de la industria es evolucionar desde una entrega documental hacia una entrega basada en preparación operacional real. Estas son algunas de las prácticas más utilizadas por empresas maduras.
Operational Readiness Review
Antes del paso a producción, se realiza una revisión formal con las áreas involucradas. Participantes comunes:
- Ingeniería.
- Operaciones.
- Arquitectura.
- Seguridad.
- NOC.
- Soporte técnico.
- Gestión de cambios.
- Proveedores.
- Dueños del servicio.
- Gestión de continuidad.
- Gestión de capacidad.
El objetivo es confirmar que la plataforma cumple las condiciones mínimas para entrar en operación.
Production Acceptance Criteria
Muchas organizaciones definen criterios medibles para aceptar una plataforma en producción. Ejemplos:
- 100% de alarmas críticas integradas.
- Dashboards operativos disponibles.
- Runbooks aprobados.
- Pruebas de failover ejecutadas.
- Backup y restore validados.
- CMDB actualizada.
- Matriz de escalamiento vigente.
- SLA y OLA definidos.
- Capacitación completada.
- Accesos operativos habilitados.
- Riesgos residuales aprobados.
- Inventario actualizado.
- Licencias verificadas.
- Evidencias de pruebas disponibles.
- Plan de rollback documentado.
Este enfoque reduce ambigüedades y facilita la toma de decisiones.
Shift-left de operaciones
Una tendencia clara es involucrar a operaciones antes en el ciclo de vida del proyecto. Esto se conoce como shift-left operations. En vez de esperar al final, operaciones participa en:
- Revisión de arquitectura.
- Diseño de monitoreo.
- Definición de KPIs.
- Identificación de riesgos.
- Validación de soporte.
- Revisión de capacidad.
- Diseño de runbooks.
- Definición de SLA.
- Preparación de pruebas operativas.
Esto ayuda a prevenir problemas antes de que la plataforma llegue a producción.
Runbooks y playbooks
El mercado está migrando desde manuales extensos hacia runbooks y playbooks prácticos, orientados a escenarios específicos. Ejemplos de runbooks útiles:
- Qué hacer si cae un nodo.
- Qué hacer si falla una interfaz.
- Qué hacer si aumenta la latencia.
- Qué hacer si se degrada un KPI.
- Qué hacer si falla la conectividad.
- Qué hacer si se llena un filesystem.
- Qué hacer si falla una integración.
- Qué hacer si expira un certificado.
- Qué hacer si falla un backup.
- Qué hacer si una alarma crítica se activa.
Un buen runbook debe incluir:
- Síntoma.
- Impacto.
- Validaciones iniciales.
- Comandos o pasos de diagnóstico.
- Acciones correctivas.
- Criterios de recuperación.
- Escalamiento.
- Contactos.
- Evidencias requeridas.
Observabilidad
En plataformas modernas, no basta con monitorear disponibilidad. La industria está avanzando hacia modelos de observabilidad. La observabilidad incluye:
- Métricas.
- Logs.
- Trazas.
- Eventos.
- Dashboards.
- Alarmas.
- Correlación.
- Experiencia de servicio.
- KPIs de negocio o servicio.
El objetivo no es solo saber que algo falló, sino entender rápidamente:
- Qué falló.
- Dónde falló.
- Por qué falló.
- Qué impacto tiene.
- Qué acción debe tomarse.
Hypercare estructurado
El hypercare ya no se maneja de forma informal. En organizaciones maduras se estructura como una fase formal del proyecto. Incluye:
- Duración definida.
- Responsables claros.
- Reuniones periódicas.
- Seguimiento de incidentes.
- Seguimiento de KPIs.
- Gestión de pendientes.
- Soporte extendido.
- Criterios de salida.
- Cierre formal.
El objetivo es asegurar una transición controlada desde el soporte de proyecto hacia el soporte operativo regular.
Automatización del handover
Cada vez más empresas automatizan partes del proceso de entrega. Áreas donde se aplica automatización:
- Validaciones preproducción.
- Generación de inventario.
- Recolección de evidencias.
- Actualización de CMDB.
- Despliegue de monitoreo.
- Creación de dashboards.
- Ejecución de pruebas.
- Validaciones de configuración.
- Revisión de cumplimiento.
- Generación de reportes.
- Remediación básica.
En entornos cloud-native, estas validaciones pueden integrarse en pipelines CI/CD, donde una plataforma no avanza a producción si no cumple ciertos controles operativos mínimos.
Modelo recomendado de checklist de recepción operacional
Un checklist efectivo debería organizarse por dominios. A continuación se propone una estructura de referencia.
1. Información general
- Nombre de la plataforma.
- Descripción del servicio.
- Dueño técnico.
- Dueño funcional.
- Dueño de negocio.
- Criticidad.
- Servicios soportados.
- Ambientes incluidos.
- Fecha de go-live.
- Ventanas de mantenimiento.
- Proveedores involucrados.
- Áreas impactadas.
2. Arquitectura y diseño
- Diagrama de alto nivel.
- Diagrama físico.
- Diagrama lógico.
- Diagrama funcional.
- Componentes principales.
- Dependencias internas.
- Dependencias externas.
- Flujos de tráfico.
- Flujos transaccionales.
- Puntos únicos de falla.
- Modelo de alta disponibilidad.
- Modelo de redundancia.
- Restricciones de diseño.
3. Conectividad
- Direccionamiento IP.
- VLANs.
- Puertos.
- Firewalls.
- Rutas.
- DNS.
- NAT.
- Balanceadores.
- Certificados.
- Dependencias de red.
- Reglas de comunicación.
- Diagramas de conectividad.
- Evidencias de pruebas de conectividad.
4. Capacidad y dimensionamiento
- Capacidad instalada.
- Capacidad proyectada.
- Supuestos de dimensionamiento.
- Límites conocidos.
- Crecimiento esperado.
- Umbrales de saturación.
- Resultados de pruebas de carga.
- Resultados de pruebas de performance.
- Plan de escalamiento.
- Requerimientos de licenciamiento.
- Requerimientos de almacenamiento.
- Requerimientos de cómputo.
- Requerimientos de red.
5. Operación
- Procedimientos diarios.
- Procedimientos semanales.
- Procedimientos mensuales.
- Validaciones de salud.
- Reinicios controlados.
- Tareas recurrentes.
- Limpieza de logs.
- Gestión de espacio.
- Gestión de certificados.
- Procedimientos de mantenimiento.
- Procedimientos de parada y arranque.
- Procedimientos de troubleshooting.
- Runbooks operativos.
6. Monitoreo y KPIs
- KPIs técnicos.
- KPIs de servicio.
- SLIs.
- SLOs, si aplican.
- Umbrales.
- Alarmas críticas.
- Alarmas mayores.
- Alarmas menores.
- Dashboards.
- Integración con NOC.
- Integración con OSS/NMS.
- Procedimientos ante alarmas.
- Correlación de eventos.
- Evidencia de pruebas de alarmamiento.
- Responsable de ajuste de umbrales.
7. Soporte y escalamiento
- Modelo de soporte L1/L2/L3.
- Contactos internos.
- Contactos de proveedores.
- Horarios de soporte.
- Soporte 24×7, si aplica.
- Tiempos de respuesta.
- Tiempos de resolución.
- Matriz RACI.
- Procedimiento de escalamiento.
- Canales de comunicación.
- Proceso de apertura de tickets.
- Proceso de seguimiento de incidentes.
- Proceso de escalamiento ejecutivo, si aplica.
8. SLA, OLA y contratos
- SLA comprometidos.
- OLA internos.
- Contratos de soporte.
- Penalidades, si aplican.
- Exclusiones.
- Ventanas de mantenimiento.
- Criterios de disponibilidad.
- Criterios de degradación.
- Tiempos de atención.
- Tiempos de resolución.
- Responsabilidades por nivel de soporte.
9. Continuidad y recuperación
- Estrategia de backup.
- Procedimiento de restore.
- Frecuencia de respaldos.
- Retención de respaldos.
- Ubicación de respaldos.
- Alta disponibilidad.
- Disaster recovery.
- RTO.
- RPO.
- Procedimientos de failover.
- Procedimientos de fallback.
- Evidencias de pruebas de recuperación.
- Plan de continuidad.
- Plan de contingencia.
10. Seguridad
- Gestión de usuarios.
- Roles y permisos.
- Cuentas privilegiadas.
- Auditoría.
- Trazabilidad.
- Hardening.
- Vulnerabilidades.
- Certificados.
- Gestión de credenciales.
- Accesos de proveedores.
- Accesos temporales.
- Integración con herramientas de seguridad.
- Evidencia de validaciones de seguridad.
- Riesgos de seguridad aceptados.
11. Evidencias de pruebas
- Pruebas funcionales.
- Pruebas de integración.
- Pruebas de conectividad.
- Pruebas de performance.
- Pruebas de carga.
- Pruebas de resiliencia.
- Pruebas de failover.
- Pruebas de backup.
- Pruebas de restore.
- Pruebas de seguridad.
- Pruebas de monitoreo.
- Pruebas de operación.
- Defectos abiertos.
- Riesgos aceptados.
- Evidencias firmadas o aprobadas.
12. Documentación del aplicativo o plataforma
- Manual de usuario.
- Manual de operación.
- Manual de administración.
- Manual de instalación.
- Guía de troubleshooting.
- Runbooks.
- Playbooks.
- Release notes.
- Inventario de versiones.
- Matriz de compatibilidad.
- Parámetros de configuración.
- Procedimientos de actualización.
- Procedimientos de rollback.
- Documentación de APIs, si aplica.
- Documentación de integraciones.
Recomendaciones para mejorar el proceso
Para fortalecer el proceso de entrega entre ingeniería y operaciones, se pueden aplicar las siguientes recomendaciones:
1. Definir criterios de aceptación desde el inicio
No se debe esperar al final del proyecto para definir qué necesita operaciones. Los criterios deben acordarse al inicio y revisarse durante todo el ciclo de vida del despliegue.
2. Involucrar a operaciones en el diseño
Operaciones debe participar en revisiones de arquitectura, capacidad, monitoreo, soporte y continuidad. Esto permite identificar riesgos antes de que la plataforma esté en producción.
3. Validar, no solo recibir documentos
El checklist debe enfocarse en validaciones reales. No basta con recibir un archivo; se debe confirmar que la información es correcta, completa y útil.
4. Usar runbooks accionables
Los manuales extensos son útiles como referencia, pero operaciones necesita guías rápidas para actuar ante incidentes. Los runbooks deben estar orientados a escenarios reales.
5. Probar monitoreo y alarmas antes del go-live
Toda plataforma debe entrar a producción con monitoreo validado, dashboards disponibles y alarmas accionables.
6. Formalizar el hypercare
El periodo post go-live debe tener responsables, duración, reuniones, métricas y criterios de salida.
7. Mantener documentación viva
La documentación no debe verse como un entregable estático. Debe actualizarse conforme cambie la plataforma, su configuración o sus procedimientos.
8. Gestionar riesgos residuales
Si la plataforma se acepta con pendientes, estos deben quedar documentados con:
- Descripción del riesgo.
- Impacto.
- Responsable.
- Fecha compromiso.
- Plan de mitigación.
- Aprobación correspondiente.
La entrega de una plataforma de telecomunicaciones desde ingeniería hacia operaciones es mucho más que completar un checklist. Es un proceso clave para asegurar que una solución pueda ser operada, monitoreada, soportada y recuperada de forma confiable. El mercado está evolucionando hacia modelos donde operaciones participa desde etapas tempranas, los criterios de aceptación son medibles, la documentación es práctica, el monitoreo es obligatorio y el hypercare se gestiona formalmente. Un checklist sigue siendo una herramienta muy valiosa, pero debe estar acompañado de validaciones reales, transferencia de conocimiento, pruebas operativas y una clara asignación de responsabilidades. En resumen, una plataforma no está realmente lista cuando termina el despliegue. Está lista cuando puede ser operada de forma estable, segura, monitoreable, soportable y recuperable. La madurez de este proceso impacta directamente en la estabilidad del servicio, la experiencia del cliente, la eficiencia operativa y la capacidad de la organización para escalar nuevas plataformas con menor riesgo.